21.08.2026
как не допустить выход канализации на потолке в кухне
Примерно 10 лет назад я решил что хочу построить себе дом. Не покупать готовый - чаще всего “дома на продажу” строятся скажем так очень топорно и с нарушением норм. А я все же инженер и посчитал что смогу разобраться и все проконтроллировать (спойлер - все получилось, но нервов потребовало достаточно). В итоге два года изучал матчасть - читал профильные форумы, разбирал СНиПы и т.д. Но так как я хоть и инженер, но по другому профилю, решил доверится профессионалам и купил готовые проект со всеми нужными частями: архитектурной, конструктивной, инженеркой. Предложение отличное - все есть, все продумано, бери и строй. Но, будучи control freak’ом, я решил все досконально проверить и воссоздать виртуальный проект дома в новомодном BIM (чуть ниже расскажу что это за зверь). Засучил рукава и взялся за дело.
В ходе построения оказалось, что не все так радужно как кажется. Кое где вентиляция проходит сквозь несущую стену, меняя расположение между этажами (чертили каждый этаж разным чертежом и не договорились), а в крышу вообше входит с поворотом в 90 градусов. Веранда находится ниже уровня среза 2 этажа только в архитектурной части, а в конструктивной лежит ровно (и как раскладывать арматуру решительно непонятно). И много похожих косяков, которые на самом деле каждому конкретному специалисту не виделись косяками. Каждый чертеж в отдельности - идеален. Но встречаясь в одно точке времени и пространства входят в несущую стену. И хоть вой хоть плакай.
Но по-настоящему меня добила не вентиляция. Меня добила канализация. Дело в том, что архитектор заложил санузел на втором этаже над гостинной, что в целом конечно ок для двухэтажного дома, но при сборке дома целиком оказалось, что канализационные трубы из него выходят на потолок кухни - а это уже мягко говоря негигеенично. То есть буквально: труба со второго этажа, по которой течёт то, что течёт по канализации, планово выводилась на потолок кухни. Той самой кухни, которая у меня смотрит на полуденное солнце.
И вот что здесь важно, ради чего я вообще это рассказываю. Ни один из проектировщиков не ошибся. Каждый раздел проекта — архитектурный, конструктивный, водопроводный — был внутри себя абсолютно корректен. Архитектор нарисовал правильные комнаты. Инженер провёл правильные трубы. Конструктор посчитал правильные стены. Ошибка родилась не внутри раздела, а на стыке разделов — там, где правильное встречается с правильным и вместе даёт нелепость. Каждый смотрел в свой чертёж и видел там порядок. Никто не смотрел в единую картину, потому что единой картины попросту не было — были отдельные чертежи, лежащие рядом. И именно для того, чтобы этой беды не было, строительная отрасль придумала целую дисциплину. Она называется BIM.
Что такое BIM
Чтобы объяснить, что такое BIM, надо сначала честно посмотреть, из чего вообще состоит проект здания. А состоит он из разделов — по числу инженерных дисциплин, каждая из которых отвечает за свою сторону дома.
Есть архитектура — то, как здание выглядит и как в нём устроено пространство: комнаты, окна, двери, планировки. Есть конструктив — несущий скелет здания: фундамент, стены, перекрытия, всё, что держит дом и не даёт ему развалится. Есть электроснабжение — проводка, щитки, розетки, освещение. Есть водоснабжение и канализация, которую инженеры коротко зовут ВК, — трубы, по которым вода приходит и уходит. Есть отопление и вентиляция, оно же ОВК (отопление, вентиляция и кондиционирование), — батареи, воздуховоды, всё, что греет и проветривает. И есть слаботочные системы — интернет, сигнализация, домофон, видеонаблюдение, всё, что работает на малых токах и передаёт сигналы, а не питание.
Каждый раздел ведёт свой специалист, и каждый рисует свой комплект чертежей. А теперь вопрос: как эти разделы согласовать между собой? Как убедиться, что труба ВК не пересечётся с балкой конструктива, а воздуховод ОВК не упрётся в несущую стену?
До BIM это делалось руками. В буквальном смысле руками. Разделы велись как отдельные комплекты чертежей, и координация между ними держалась на глазе главного инженера проекта - ГИПа. Он брал чертежи разных разделов и сверял их между собой — иногда буквально накладывая одну кальку на другую на просвет и высматривая, не пересекается ли где труба с балкой. Это была честная, тяжёлая, внимательная работа — и абсолютно негарантированная. Стоило ГИПу устать, отвлечься, не наложить нужную пару калек — и коллизия проскакивала в стройку. Ровно так труба и оказывалась в несущей стене: не потому что кто-то ошибся в расчёте, а потому что человеческий глаз не в силах одновременно удержать шесть разделов сразу. А монтажники учились материться…
flowchart TD
subgraph AFTER["После: единая модель"]
M["Единая модель здания"] --> P1["План этажа"]
M --> P2["Разрез, фасад"]
M --> P3["Схемы разделов"]
end
subgraph BEFORE["До: разрозненные комплекты"]
D1["Чертежи архитектуры"] --> EYE["Глаз ГИПа (калька на просвет)"]
D2["Чертежи конструктива"] --> EYE
D3["Чертежи ВК и ОВК"] --> EYE
EYE --> RISK["Коллизия проскакивает в стройку"]
end
До BIM разделы велись отдельными комплектами, а координация держалась на глазе ГИПа — и коллизия могла проскочить. После — все виды рождаются из одной модели, и расходиться им попросту неоткуда.
BIM возник как ответ на эту боль. И вот тут я обязан сразу разбить самое частое заблуждение, потому что без этого весь дальнейший разговор рассыплется. Многие думают, что BIM — это когда чертят в 3D вместо 2D. Красивые объёмные картинки вместо плоских планов. Это неправда, точнее — это самая поверхностная и наименее важная часть.
Суть BIM совсем в другом. Суть в том, что есть единая информационная модель здания, одна на все разделы, и из неё чертёж получается как проекция. Не наоборот — не «нарисовали планы, потом собрали из них модель», а именно из модели рождается любой нужный вид: план этажа, разрез, фасад, схема отдельного раздела. Все они — проекции одной и той же модели, взятой под разными углами. И второе, ещё более важное: элементы этой модели несут информацию, а не являются геометрическими примитивами. В обычном чертеже труба — это две линии, отрезки на бумаге, и всё, что о них известно, — их координаты. В модели BIM труба — это труба: она знает свой диаметр, свой материал, свой уклон, знает, что она — часть системы ВК. Она не нарисована, она описана. Отсюда и буква I в аббревиатуре — Information. BIM это не про три измерения вместо двух. BIM это про то, что в модели живут не линии, а осмысленные объекты, знающие о себе всё.
flowchart LR
A["Архитектура"] --> M["Единая информационная модель здания"]
K["Конструктив"] --> M
VK["ВК"] --> M
OVK["ОВК"] --> M
EL["Электрика и слаботочка"] --> M
M --> P1["План этажа"]
M --> P2["Разрез, фасад"]
M --> P3["Спецификации"]
M --> P4["Сметы"]
Все разделы вносят свои элементы в одну модель, а любой чертёж, спецификация или смета рождается из неё как проекция — не наоборот.
Зачем нужна единая модель
Что нам даёт эта единая модель? Первое и самое очевидное — поиск коллизий прямо в модели, до стройки. Раз труба знает свой объём в пространстве, а балка знает свой, то их пересечение — это простой вопрос геометрии, который считает машина. Не глаз уставшего ГИПа, не наложение калек на просвет, а алгоритм, который берёт все элементы всех разделов и честно проверяет: не занимают ли двое из них одну и ту же точку пространства. Труба сквозь несущую стену, стояк над кухней — всё это модель ловит заранее, показывает красным и говорит: вот здесь конфликт, разберитесь.
И вот тут прячется мысль, которую я считаю ключевой не только для строек, но и для чего угодно вообще. Чем раньше ты ловишь ошибку, тем дешевле она обходится, и разница тут не в разы, а на порядки. Коллизия, пойманная в модели, — это пара кликов и десять минут работы инженера. Та же коллизия, пойманная на стройке, — это уже перекладка труб, переделка перекрытий, простой бригады. Я всем привожу пример - подвинуть стенку в модели - три секунды, подвинут стенку после залития бетоном - работа ребят с перфоратором. А та же коллизия, обнаруженная жильцом, когда он въехал и с потолка кухни закапало, — это катастрофа, суд и переделка всего. Одна и та же ошибка стоит копейки, тысячи или миллионы — в зависимости только от того, на каком этапе её поймали. Единая модель сдвигает поимку ошибки максимально влево, к самому началу, и этим экономит целое состояние.
Второе, что даёт единая модель, — связность видов. Раз все чертежи это проекции одной модели, то изменение в одном виде мгновенно расходится по всем остальным. Подвинул стену на плане — она подвинулась и на разрезе, и на фасаде, и в спецификации. Не надо руками синхронизировать десяток чертежей, надеясь ничего не забыть; модель одна, и правка в ней автоматически становится правкой везде. Расхождение между видами становится попросту невозможным — не потому что за ним следят, а потому что видам неоткуда разойтись, они все смотрят на один источник.
А дальше модель начинает обрастать новыми гранями, выходящими за пределы геометрии. Добавляют время — и говорят о 4D: модель знает не только где стоит элемент, но и когда он монтируется, то есть в неё встроен график стройки. Добавляют стоимость — и говорят о 5D: каждый элемент знает свою цену, и модель сама считает смету. Я не буду сейчас в это углубляться, для нашего разговора важно только одно: модель — не застывшая геометрия, а нечто, к чему прирастают всё новые и новые грани. Начиналось с формы, добавилось время, добавились деньги. Модель — это то, что накапливает грани.
Решатель
И вот теперь я хочу ввести понятие, ради которого, по большому счёту, вся эта статья и затевалась. Понятие центральное, и я буду возвращаться к нему до самого конца.
Всё, что я описал выше про поиск коллизий, делает не человек. Это делает отдельная штука, которую я буду называть решателем. Решатель — это не редактор, в котором рисуют модель, и не визуализатор, который показывает красивые картинки. Решатель — это вычислитель и проверяльщик целостности модели. Его единственная работа — взять модель целиком и ответить на вопрос: непротиворечива ли она? Нет ли в ней элементов, которые конфликтуют друг с другом? Не занимают ли двое одну точку, не нарушен ли норматив, не висит ли труба в воздухе? Решатель не создаёт и не украшает — он проверяет. В мире BIM роль решателя играют сами платформы: в Revit проверки целостности встроены в редактор, а Navisworks специально заточен на сведение разделов и поиск коллизий между ними.
flowchart LR
M["Модель здания"] --> S["Решатель (проверяльщик целостности)"]
R["Нормативы и правила"] --> S
S --> V1["Непротиворечива: коллизий нет"]
S --> V2["Список коллизий: труба сквозь стену, стояк над кухней"]
Решатель — не редактор и не визуализатор. Он берёт модель и правила и выдаёт детерминированный вердикт: либо доказанная непротиворечивость, либо точный список коллизий.
И вот что в этом решателе самое главное — он детерминированный. Он даёт точный, воспроизводимый, доказуемый ответ. И это не случайность, а следствие природы предмета. Геометрия формализуема: положение элемента в пространстве — это координаты, объём — это множество точек, и пересечение двух объёмов — строго вычислимая вещь. Нормативы тоже формализуемы: «уклон канализации не менее стольких-то процентов», «расстояние от трубы до кабеля не менее стольких-то сантиметров» — это правила, которые машина проверяет однозначно. А раз и геометрия, и нормы поддаются формализации, то решатель способен не просто заподозрить проблему, а доказать непротиворечивость модели. Он не говорит «кажется, всё в порядке» — он говорит «в этой модели коллизий нет», и этому можно верить как математической теореме. Запомним это слово — доказать. Оно нам ещё пригодится, и именно вокруг него всё повернётся.
Поворот к софту
А теперь давайте сделаем шаг в сторону и посмотрим на разработку программного обеспечения. И я утверждаю, что у софта есть ровно те же самые «разделы», что у здания. Просто мы их по другому называем.
Смотрите сами. Есть PRD и ТЗ — описание того, что мы вообще строим, требования к продукту. Это архитектура нашего дома — то, как он устроен для пользователя. Есть ADR — записанные архитектурные решения, почему выбрано так, а не иначе. Есть дизайн и UX — то, как продукт выглядит и как в нём устроено взаимодействие. Есть код — несущий конструктив, то, на чём всё держится. Есть тест-кейсы — описания того, что и как проверяется. Есть автотесты — их машинная реализация. Есть документация. Есть инфраструктура — то, на чём всё это живёт и работает. Каждый из этих артефактов ведёт свой человек или своя роль, и каждый по-своему прав внутри себя.
И у софта — ровно та же болезнь, что у дома до BIM. Разделы расходятся. Дизайн говорит одно, код делает другое, тесты проверяют третье. Требования описывают продукт, каким он был полгода назад, а с тех пор его переделали дважды и забыли обновить ТЗ. Документация врёт, потому что её никто не трогал с прошлого года. Каждый артефакт внутри себя, может, и корректен — но вместе они противоречат друг другу. И это ровно те же проблемы дома из моего пролога: по отдельности и первый этаж хорош, и второй хорош, а вместе труба выходит на потолок кухни. По отдельности и код хорош, и тесты хороши, а вместе — тесты зелёные, а продукт делает не то. Разделы правильные, стык — нет.
Что делают со зданием, когда разделы расходятся? Заводят единую модель, из которой все чертежи — проекции. И я предлагаю ровно ту же идею для софта. Назовём её по аналогии SIM — единая информационная модель софта, из которой все артефакты — это её виды. ТЗ, ADR, дизайн, код, тесты, документация — не самостоятельные документы, лежащие рядом и расходящиеся, а проекции одной модели, взятой под разными углами. Как план этажа и разрез — это один дом с двух сторон, так требование и код — это одна система с двух сторон.
flowchart LR
SIM["Единая модель софта (SIM)"] --> V1["ТЗ и PRD"]
SIM --> V2["ADR"]
SIM --> V3["Дизайн и UX"]
SIM --> V4["Код"]
SIM --> V5["Тест-кейсы и автотесты"]
SIM --> V6["Документация"]
ТЗ, ADR, дизайн, код, тесты и документация — не самостоятельные документы, лежащие рядом, а виды одной модели софта, взятой под разными углами.
И вот здесь я обязан поставить огромный, жирный, важнейший дисклеймер, без которого вся аналогия превращается в опасную глупость. Я не утверждаю поэлементного соответствия. Я не говорю, что каждому требованию отвечает ровно один класс, а каждому тест-кейсу — ровно одна функция, и что всё это можно связать стрелочками один в один. Это было бы ложью и вредной ложью. В софте такого соответствия нет и быть не может. Переносится не структура «элемент модели = элемент чертежа». Переносится один-единственный принцип: видов много, и ценность — не в самих видах, а в согласованности между ними. Не в том, что есть код, и есть тесты, и есть ТЗ. А в том, что они не противоречат друг другу, потому что выводятся из одного и того же. Вот это, и только это, я предлагаю забрать из BIM в софт. Всё остальное — детали, в которых аналогия неизбежно поедет, и это нормально.
Я придумал — потом нашёл
Здесь надо честно сделать паузу и признаться. Когда эта мысль про единую модель софта у меня сложилась, я, как водится, решил, что придумал нечто новое. А потом, как тоже водится, пошёл искать — и обнаружил, что об этом думали до меня, и думали основательно.
Ближе всего к моей интуиции оказался Orthographic Software Modeling Колина Аткинсона — там прямо про то, что артефакты софта суть ортогональные проекции одной подлежащей модели (Single Underlying Model), ровно как виды в черчении. В ту же сторону копают в Vitruvius из KIT — фреймворк для согласованного view-based развития систем. Забавно, что даже аббревиатура SIM оказалась занята: System Information Modelling (I&E Systems, 1994) — это, по сути, тот же BIM, но для физических инженерных систем. Рядом стоят и смежные направления: MBSE и SysML в системной инженерии, OSLC для связывания артефактов между инструментами, living documentation, да и сами ADR как способ не терять решения. То есть поле давно вспахано, и ничего принципиально нового в самой идее нет.
Так в чём же тогда новизна? А новизна не в идее. Идея стара. Новизна в том, что только сейчас появилась возможность её реализовать — по-настоящему, а не на бумаге. И вот почему появилась — об этом весь остаток статьи.
Почему у софта нет детерминированного решателя
Вернёмся к решателю. В BIM он детерминированный и умеет доказывать непротиворечивость. Естественный вопрос: почему нельзя сделать такой же для софта? Взять SIM, натравить на неё решатель, и пусть он доказывает, что код не противоречит ТЗ.
А нельзя. И причина глубокая, не техническая.
Модель здания описывает физический объект с вычислимыми свойствами. Труба имеет диаметр, координаты, объём — всё это числа, и противоречие между двумя элементами есть противоречие между числами, а его машина считает. Артефакты же софта — это материализация мыслей на естественном языке. Требование написано словами. ADR написан словами. Код, конечно, формален, но смысл, который он воплощает, — это опять же мысль, выраженная словами в голове разработчика.
Возьмём пару. Требование: «пользователь не может вывести больше денег, чем есть на счёте». И код, где проверка баланса стоит, но выполняется до того, как учтена комиссия за вывод. Противоречат ли они? Да. Но это противоречие смысла, а не вычисления. Чтобы его увидеть, надо понять, что значит «есть на счёте», сообразить, что комиссия — это тоже расход, и соотнести намерение автора требования с тем, что реально делает код. Никакое пересечение объёмов тут не поможет — здесь надо понимать значение слов.
flowchart TD
subgraph DET["Решатель BIM"]
G["Предмет: геометрия и нормативы"] --> GF["Формализуем"]
GF --> GP["Детерминированный ответ: доказательство непротиворечивости"]
end
subgraph NON["Решатель софта"]
M["Предмет: смысл на естественном языке"] --> MF["Не формализуется"]
MF --> MP["Вероятностный ответ: обоснованное подозрение"]
MP --> MV["Цикл проверки и человек в контуре"]
end
Два решателя различаются природой предмета: геометрия формализуема и допускает доказательство, смысл на естественном языке — нет, поэтому здесь ответ вероятностный и требует цикла проверки с человеком в контуре.
«Но есть же формальные методы!» — скажет въедливый читатель. Есть. TLA+, Coq, доказательства свойств. Они работают, и работают прекрасно. Но у них есть цена: чтобы ими воспользоваться, надо сначала перевести мысль в формализм — а этот перевод дорог, требует редкой квалификации и сам по себе ненадёжен. Формализуя требование, ты можешь ошибиться в формализации ровно так же, как в самом требовании, и получить строгое доказательство неправильного утверждения. Мысль, переведённая в формулу, — это уже не совсем та мысль.
И это не гадание. За последние сорок лет было немало попыток формализовать разработку целиком: CASE-инструменты, MDA с его model-driven подходом, round-trip engineering, где код и модель должны были синхронизироваться автоматически. Все они, при всём уважении и при отдельных нишевых успехах, в широкую практику не вошли. И причина, я убеждён, одна и та же: предмет не формализуется. Софт — это застывшая мысль, а мысль не сводится к геометрии.
И тут я обязан сказать честно, где аналогия с домом ломается. Здание строят один раз. Спроектировали, проверили модель, построили — и всё, дом стоит. Софт же меняется непрерывно, каждый день, каждым коммитом. А это значит, что согласованность видов для софта — не разовая задача «проверили перед стройкой», а постоянная. Модель здания замирает в момент сдачи; модель софта живёт, дышит и расходится ровно потому, что её всё время трогают. Решатель здесь нужен не один раз, а всегда. Это важное различие, и я не хочу его замазывать красивой аналогией: дом строят, софт выращивают, и это меняет всё.
ИИ как недетерминированный решатель
А теперь — то, ради чего всё писалось. И я нарочно говорю в настоящем времени, потому что это не прогноз и не мечта, а то, что уже работает сегодня.
Смотрите, где мы застряли. Детерминированный решатель для софта невозможен, потому что противоречия в софте — это противоречия смысла, выраженного естественным языком, а естественный язык детерминированной машине недоступен. Но у нас теперь есть машина другого рода. LLM работает именно со смыслом на естественном языке — ровно с тем материалом, который недоступен решателю из BIM. И вот ключевой разворот в голове, который надо совершить: решатель не обязан быть детерминированным. Он обязан быть полезным, с некоторой гарантией должен решить задачу. BIM приучил нас, что решатель доказывает. Но доказательство — это роскошь формализуемого предмета. Там, где предмет не формализуется, мы отказываемся от доказательства в пользу пользы — и это честная сделка.
Что конкретно уже сегодня умеет такой недетерминированный решатель? Перечислю проверки, которые работают прямо сейчас, не в теории.
Он сверяет требование с кодом и находит расхождение — читает ТЗ, читает реализацию и говорит: вот здесь код делает не то, что написано в требовании. Он находит затронутые грани, когда меняется требование, — говорит: ты поменял вот это ТЗ, значит, поедут вот эти куски кода, вот эти тесты и вот этот раздел документации, иди проверь. Он проверяет, покрывают ли тест-кейсы заявленные требования, — сопоставляет корпус требований с корпусом тестов и показывает дыры. Он ловит конфликт новой фичи со всем корпусом накопленных спек — говорит: то, что ты задумал, противоречит вот этому решению, принятому полгода назад. Это и есть поиск коллизий для смыслов. Ровно то же, что делает Navisworks с трубами и балками, только предмет — не геометрия, а смыслы.
flowchart TD
CH["Изменили одну грань (например, ТЗ)"] --> FIND["Решатель находит затронутые грани: код, тесты, документацию"]
FIND --> DIV["Выявляет расхождения между видами"]
DIV --> AC["Actor-critic: актор правит, критик перечитывает реальный артефакт"]
AC -->|расхождения остались| DIV
AC -->|расхождений нет| CONV["Сходимость: виды снова согласованы"]
Недетерминированный решатель за работой: меняется одна грань — находятся затронутые, вскрываются расхождения, actor-critic цикл сводит виды обратно к согласованности.
И вот что мне особенно дорого: зерно этого уже посеяно. Вся машинерия из моей первой статьи — это и есть заготовка недетерминированного решателя. Фиксация договорённостей в артефактах — это и есть построение той самой единой модели, накопление её видов. А actor-critic цикл — это и есть работа решателя: критик, который читает реальный артефакт и сверяет его с задачей, буквально проверяет одну грань модели на согласие с другой. Критик, читающий код и сверяющий его со спекой, — это решатель, ищущий коллизию между двумя видами. Я, оказывается, строил решатель, ещё не зная, что строю именно его.
Но честность прежде всего, поэтому про пределы. Этот решатель вероятностный. Он ошибается. Он не даёт доказательства — он даёт обоснованное подозрение, а не теорему. Из этого прямо следуют две вещи. Во-первых, нужен цикл: одиночный ответ ненадёжен, надёжность набирается прогонами и перекрёстной проверкой. Во-вторых, нужен человек в контуре — тот, кто принимает финальное решение там, где решатель лишь советует. И заметьте, это не признак незрелости. Детерминированный решатель в стройке тоже не отменил ГИПа — он снял с него рутину сверки калек на просвет, но подпись под проектом по-прежнему ставит человек и несет за нее отвественность. Недетерминированный решатель для софта делает ровно то же: снимает рутину, но не ответственность.
Финал
В самом конце позволю себе тихое эхо первой статьи. Там я говорил, что работа инженера никуда не девается — она смещается. Здесь то же самое, только сказанное с другой стороны.
Единая модель в стройке не отменила проектировщиков. Она сделала кое-что другое: она убрала целый класс ошибок — тех, где «разделы не сошлись», где труба лезет в несущую стену, а канализация выходит на потолок кухни. И этим она подняла планку: раз глупых коллизий больше нет, инженер занимается тем, что действительно требует головы, а не выискиванием пересечений на просвет.
С софтом происходит ровно это. Спека и код не потому согласованы, что кто-то заставил их совпасть, а потому что они — виды одной модели, и им неоткуда всерьёз разойтись, пока за целостностью следит решатель. Требование, код, тесты, документация перестают быть отдельными документами, живущими своей жизнью и тихо друг другу противоречащими. Они становятся проекциями одного целого. А работа инженера смещается туда же, куда и в стройке: от написания отдельных строк — к проектированию самой модели и её граней, к тому, чтобы правильно задать, из чего состоит система и какими видами мы на неё смотрим. Мы всё меньше пишем разрозненные артефакты и всё больше строим единую модель, а следить за тем, чтобы её виды не разошлись, поручаем решателю — пусть недетерминированному, пусть ошибающемуся, но уже работающему. И, как в стройке, оставляем рядом человека, который ставит подпись.
18.08.2026
Давно экспериментирую с агентами и LLM разработкой, но вот только сейчас собрался статью оформить. Думаю будет некоторый цикл, потому что мыслей несколько и они тянут на несколько, но начнем с главного - с скажем так азов.
Грустная история или как потратить все токены впустую
Когда случился прорыв в агентах (стало понятно, что они теперь не просто могут, а могут эффективно), я начал гонять их и в бровь и в гриву. Взял OpenCode (в основном потому, что начинал с бесплатных всяких моделек, но потом понравилось), и начал гонять агентскую разработку на петпроектах. И через какое-то время наткнулся на Oh-My-Opencode, который обещал за счет специализированных агентов (Сизифус и компания), решать задачи эффективно. И первые заходы были многообещающими, ultrawork выглядит классно, гораздо лучше чем предыдущие мои попытки workflow через plan + build. Однако радость была недолгой.
Для того, чтобы решать какие-то нормальные задачи, я подключил платную модельку (тогда это была glm-4.7 и платил я за нее через агрегатора). И через какое-то время столкнулся с тем, что деньга, которую я плачу агрегатору - выросла (причем заметно), а количество решенных (не решаемых, а именно решенных задач), значительно упало. При этом нельзя было сказать что агенты прям ничего не делали - трудились в поте лица. Налицо так называемое ИБД (Изображение Бурной Деятельности). Я эксперимент остановил и пошел разбираться что к чему.
И оказалось, что все не очень хорошо тут. От мелких проблем следущего характера: агент начал реализовывать то, от чего мы сознательно отказались; завёл сущность с тем именем, которое мы явно забраковали; Принял решение, прямо противоречащее решению, принятому в начале той же самой сессии. И самое обидное — он делал это уверенно, без тени сомнения.
Да я знаю, “допустил компактификацию - проиграл”, особенно на тогдашних модельках с коротким контекстом (это сейчас 1М никого не убедишь, а тогда доступный контекст был сильно меньше). Но проблема была в том, что агент как будто забывал договоренности, достигнутые ранее, как будто ее и не было.
А её и не было. Точнее, она была — но жила только в нашем с ним разговоре, в прокрутке чата, которая к тому моменту уже не помещалась в окно. Договорённости нигде не были зафиксированы, поэтому они попросту не пережили длину задачи. Контекст протух, а вместе с ним растворились и все решения, которые я по наивности считал принятыми.
И вот тут я поймал важную мысль. То, что мы называем «агентской разработкой», на бо́льшую часть состоит вовсе не из агента. Агент — это ядро, языковая модель, и она в этой истории ни в чём не виновата. Виноват конвейер вокруг неё, которого попросту не было (или в случае с oh-my-opencode был, но недокрученный). Провал случился не потому, что модель «слабовата», а потому, что не было контекста — зафиксированных договорённостей, переживающих время, — и не было проверки — момента, где кто-то сверил бы сделанное с тем, о чём договаривались.
Вот на этих двух китах — контекст и цикл проверки — и держится всё остальное. О них и моя первая статья. Название инструмента, которым вы обвязываете модель, вторично; первично то, что вы кладёте модели на вход и как проверяете то, что она отдаёт на выход. Дальше я разберу обоих китов по отдельности, но сначала — короткая остановка на теме, вокруг которой ломается больше всего копий и которая при этом значит меньше всего.
flowchart TD
K["Контекст (спеки, SDD, AGENTS.md)"] --> P["Конвейер агентской разработки"]
C["Цикл проверки (actor-critic)"] --> P
P --> R["Результат нужного качества"]
Конвейер агентской разработки держится на двух китах: контекст задаёт правильный вход, цикл проверки обеспечивает правильный выход.
Харнес, вокруг которого зря ломают копья
Харнес — это та обвязка, через которую вы разговариваете с моделью. Я работаю с двумя: OpenCode (отличная штука для китайских моделей) и ClaudeCode (отличная штука, если вы работаете с моделями Anthropic). Про остальные ничего сказать не могу, потому что не щупал, а гнать напраслину не хочу.
Так вот, главный мой вывод прост: TUI-варианта достаточно. Терминального интерфейса хватает, чтобы инструктировать агента, наблюдать за его работой и просматривать результаты — а это ровно то, что нужно в девяноста процентах случаев. Когда же нужен детальный разбор — вчитаться в диф, походить по коду, поставить точку останова, — я просто открываю стандартную IDE для конкретной платформы. Терминал и IDE прекрасно делят обязанности: один смотрит за процессом, другая помогает копаться в результате.
Отсюда контринтуитивный вывод. Выбор между OpenCode и ClaudeCode (или еще каким) слабо влияет на конечный результат. А значит, привычный спор «каким харнесом писать с агентами» — это не тот спор. Он греет душу, но приближает нас к цели. Настоящий вопрос не «каким харнесом, а «какой процесс»: что вы кладёте на вход и как проверяете выход. Именно туда я и предлагаю перенести фокус, и весь остаток статьи — про процесс, а не про инструмент.
Одна ремарка, чтобы закрыть тему обвязки и больше к ней не возвращаться. MCP и скиллы — это конкретные умения, которыми вы доукомплектовываете агента: сходить в такую-то систему, уметь такую-то операцию. Именно так с ними и надо работать. Но оркестрацию — то, кто кого запускает, кто кого проверяет, как устроен поток работы — на них строить не стоит (тут я говорю не строго, потому что, например, команды ClaudeCode которые осуществляют оркестрацию - это тоже своего рода скиллы, но скиллы особенные). Оркестрацию лучше строить через агентов. Умения — это про «что агент может», оркестрация — про «как агенты взаимодействуют», и путать эти уровни не надо. На этом про инструменты всё, идем к нашим китам.
Кит первый: контекст
Начнём с фундамента, потому что без него не стоит и всё остальное.
Самый первый и совершенно необходимый слой контекста — это статические файлы, вроде AGENTS.md или CLAUDE.md. Туда кладут стек, команды сборки и тестов, конвенции проекта, стиль именования, устройство репозитория — всё то, что верно для проекта в целом и меняется медленно. Это тот минимум, без которого агент будет заново открывать Америку в каждой сессии: искать, как тут запускаются тесты, гадать, каким образом у вас принято раскладывать файлы. Такой файл нужен, он работает, и с него надо начинать, и начинать обязательно! Тут я никаких откровений не обещаю.
Откровение начинается с вопроса: а чего в этих файлах принципиально нет?
А нет в них того, что привязано к конкретной задаче. Assumptions, из которых вы исходите именно сейчас. Требования, которые вам поставили под эту фичу. Вводные, которые вы получили от продакта в устном разговоре. И, что важнее всего, причины принятых решений — почему выбран этот подход, а не соседний, от чего вы сознательно отказались и почему. Всё это в AGENTS.md не положишь: оно живёт не проектом, а задачей, и через неделю сменится другим. По природе своей это знание задачное, а не проектное.
И где же оно тогда живёт? В голове разработчика! В лучшем случае — обрывками в тикетах вашего трекера задач. А значит, чаще всего оно попросту забывается — тут никакой магии нет. Именно эту боль я и описал в прологе: договорённости, которые нигде не зафиксированы, не переживают длину задачи. Они испаряются из окна контекста агента ровно так же, как испаряются из памяти человека через месяц после релиза. Мы потеряли их не из-за слабости модели, а потому что не было места, где они бы хранились в форме, пригодной и для агента, и для нас.
И такое место на самом деле существует и называется спекой.
Спека — это не бюрократия и не дань процессу. Спека — это дистиллят, материализация мыслей, вынутых из головы наружу. Тех самых assumptions, требований и причин, которые иначе растворились бы. Вы садитесь и проговариваете задачу словами: что делаем, из чего исходим, чего явно не делаем, почему именно так. И у этого действия двойная польза, что на самом деле редкость. С одной стороны, агент наконец-то получает контекст задачи — не проектный, а именно задачный, тот, которого ему всегда не хватало. С другой стороны, вы сами получаете проверяемую формулировку задачи. Ведь пока мысль крутится в голове, она кажется стройной; стоит записать — и половина дыр вылезает наружу. Спека дисциплинирует автора не меньше, чем помогает агенту.
Тут возникает возражение, которое я слышу постоянно: окно контекста ограничено, а вы предлагаете накидать в него ещё и спеки. Не захлебнётся ли агент? Не потеряет ли он нить, утонув в деталях?
flowchart TD
O["Оркестратор (чистый контекст)"]
O -->|делегирует черновую работу| S["Субагент (засоряет свой контекст: файлы, варианты, поиск)"]
S -->|"отдаёт дистиллят (ответ, факт, вывод)"| O
S -.->|замусоренное окно выбрасывается| X["выброшено"]
Оркестратор делегирует черновую работу субагенту. Субагент засоряет собственное окно, но возвращает только дистиллят — контекст оркестратора при этом не страдает.
И вот здесь — самое контринтуитивное место всего этого кита. Бюджет контекста решается не экономией промпта. Инстинкт подсказывает ужиматься: писать короче, класть меньше, беречь окно. Инстинкт неверен. Настоящий ответ на «окно кончается» — не ужимать, а делегировать. И если подумать, мы - человеки, именно так и делаем: большой начальник не разбирается сам в задаче, он отправляет конкретного специалиста сделать это и принести ему выжимку.
Смотрите, как это устроено. У оркестратора — главного агента, ведущего задачу, — контекст должен оставаться чистым: в нём только суть, только нить рассуждения, только договорённости. А вся черновая работа — перелопатить двадцать файлов, чтобы понять, где объявлена функция; прочитать половину модуля, чтобы восстановить логику; перебрать варианты и отбросить неудачные — отдаётся субагенту. Субагент засоряет своё окно этой чёрной работой до отказа, а наверх отдаёт дистиллят: короткий ответ, вывод, найденный факт. Его замусоренное окно после этого можно выбросить. А контекст оркестратора при этом не пострадал ни на строчку — он получил чистый результат, не увидев грязи, в которой этот результат добывался.
Это ровно та боль про захлебнувшийся контекст, о которой я говорил. Оркестратор тонет не потому, что задача большая, а потому, что мы валим в его окно то, чего там быть не должно. Правильный конвейер устроен так, что грязь остаётся внизу, а наверх поднимается только дистиллят.
Я использую слова “грязь” и “дистиллят”, но не стоит понимать их буквально. “Дистиллят” может быть “грязью” другого уровня, это просто удачные на мой взгляд метафоры.
Теперь сделаем следующий шаг и превратим спеку из документа в метод. Пока спека просто лежит рядом и её при желании можно почитать — это документ, не более. Но её можно поставить иначе: сделать спеку входом реализации. Не сопровождением постфактум, не отпиской «для галочки», а тем артефактом, который ведёт работу агента с самого начала и до конца. Агент не пишет код, а потом описывает, что написал; агент читает спеку и по ней реализует. Вот в этом развороте и состоит разница между спекой как документом и SDD — spec-driven development — как практикой. В первом случае спека описывает прошлое, во втором — направляет будущее. Практика начинается там, где артефакт из свидетеля превращается в руководителя.
И тут я обязан быть честным, иначе получается слишком глянцево. Спека — не панацея, и сама она бывает замусорена. Стоит поручить черновик спеки агенту, и он с энтузиазмом впишет туда требования, которых никто не заявлял: додумает граничные случаи, притащит фичи из соседних проектов, нафантазирует ограничения из воздуха — знакомо, не правда ли? Спека, раздутая домыслами, — это отдельная боль, и она хуже отсутствия спеки, потому что домысел, записанный уверенным тоном, выглядит как требование. Кто-то должен это отфильтровать: отделить заявленное от придуманного. Либо человек глазами, либо — что интереснее — отдельный actor-critic цикл дистилляции, где один агент пишет, а другой вычищает.
Но это уже не про контекст. Это про цикл. И это ровно тот мост, по которому мы переходим ко второму киту.
Кит второй: актор-критик цикл
Если первый кит отвечает на вопрос «что кладём на вход», то вторая — на вопрос «как проверяем выход». И начать я хочу не с механики, а с того, как вообще устроены определения агентов, потому что именно здесь прячется главная аналогия статьи.
Хорошая архитектура ПО стоит на нескольких принципах, и оказывается, что определения агентов подчиняются ровно тем же. Я вижу тут три аспекта.
Первый — изоляция контекста. Каждый субагент работает в своём чистом окне, не видя чужой грязи и не засоряя своей. Это ровно то делегирование, о котором шла речь в первом ките, но взятое как принцип дизайна: изоляция — не побочный эффект, а цель. Как в хорошем коде модуль не лезет во внутренности соседа, так и агент не тащит в своё окно то, что его не касается. Программисты увидят тут инкапсуляцию ООП.
Второй — разделение ролей. Один агент — одна ответственность. Это буквально SRP, только для агентов. Агент, который и пишет спеку, и реализует код, и сам себя проверяет, — это тот же божественный класс, что и в плохом коде: он делает всё и не делает ничего хорошо. Гораздо честнее развести роли: этот пишет, тот проверяет, третий дистиллирует. Тот кто хоть раз был руководителем увидит тут формирование правильной оргштатной структуры.
Третий — ограничение прав и инструментов. И это не мера безопасности, а часть дизайна. Критики — read-only: они читают и выносят вердикт, но ничего не меняют. Исполнители — пишут. Разведение прав по ролям — это то, что делает роли настоящими, а не номинальными. Критик, у которого есть право дописать код, слишком легко поддастся соблазну «сам исправлю» вместо «отправлю на доработку» — и перестанет быть критиком. Из этих трёх аспектов, кстати, прямо растут мотивы для критиков: и боль спеки с домыслами, и боль недостоверного отчёта лечатся именно наличием отдельной проверяющей роли с правильно урезанными правами (и может быть даже другой моделью).
flowchart LR
OR["Оркестратор"]
OR -->|назначает| A["Актор (исполнитель)"]
OR -->|назначает| CR["Критик(и) (read-only)"]
A -->|производит артефакт| ART["Артефакт (код, спека, текст, промпт!)"]
ART -->|читает реальный результат| CR
CR -->|замечания / апрув| OR
Механика actor-critic: актор производит артефакт, критик читает реальный результат (а не отчёт актора), замечания возвращаются актору. Цикл продолжается до апрува.
Теперь сама механика. Она называется actor-critic, и я беру этот термин как метафору, без всякой математики из обучения с подкреплением. Устроено всё так: оркестратор берёт задачу, назначает одного агента актором — исполнителем, — а других агентов критиками — проверяющими. Актор делает работу и рапортует: готово. И вот тут ключевой момент, ради которого всё и затевалось: критик не доверяет отчёту актора. Совсем. Отчёт «сделано» — это не доказательство, а заявка. Критик идёт и читает реальный результат — код, а не рассказ о коде. Оркестратор гоняет этот цикл: актор доработал по замечаниям, критики перечитали реальный результат, и так по кругу. Разработка живыми людьми с обязательным code-review в Pull/Merge Request’ах это именно тот же самый актор-критик цикл.
Почему это важно до фанатизма? Потому что вторая боль из моей практики — недостоверный отчёт агента. Агент говорит «сделано», а на деле сделано наполовину, или сделано, но сломано, или сделано не то. Языковая модель по своей природе склонна к благодушному «всё готово». И единственное противоядие — проверяющий, который принципиально не верит словам и смотрит на артефакт. Отчёт легко подделать себе же; работающий код — трудно, а насколько разных аспектов работающего кода (тесты, спека, качество) - подделать практически невозможно.
А теперь — кульминация. Потому что самое интересное в actor-critic не в том, что он есть, а в том, что одна и та же механика работает на трёх уровнях сразу.
flowchart TD
subgraph L1["Уровень 1: спека"]
A1["Актор пишет спеку"] --> C1["Критик дистиллирует: убирает домыслы"]
C1 --> A1
end
subgraph L2["Уровень 2: код"]
A2["Актор реализует по спеке"] --> C2["Критики проверяют реальный код"]
C2 --> A2
end
subgraph L3["Уровень 3: агенты"]
A3["Актор переписывает промпт агента"] --> C3["Критик проверяет новое определение"]
C3 --> A3
end
L1 --> L2
L2 --> L3
SES["Накопленные сессии (боли, систематические ошибки)"] -->|входные требования к улучшению промптов| L3
Одна и та же механика actor-critic работает на трёх уровнях: спека, код и сами промпты агентов. Накопленный опыт сессий замыкается обратно на уровень агентов — конвейер улучшает сам себя.
Подход актор-критик - фрактальный!
Уровень первый — спека. Актор пишет спеку, критик её дистиллирует: вычищает домыслы, оставляет заявленное. На выходе — чистый контекст. Помните боль раздутой домыслами спеки из первого кита? Вот её решение, и решается она тем же самым циклом.
Уровень второй — код. Актор реализует по спеке, критики проверяют реальный результат: читают код, гоняют его в голове, ищут расхождение с задачей. Также часть критиков могут вообще инициировать QA-пайплайн (автотесты и тд). Классический контроль качества, только встроенный в конвейер, а не приделанный сбоку.
Уровень третий — и вот тут, надеюсь, у вас щёлкнет — сами агенты. Определения и промпты агентов, которыми вы всё это делаете, — это тоже артефакт. Такой же текст, как спека, такой же продукт, как код. А раз это артефакт, его можно прогнать через тот же цикл. Механика тут такая. Вы эксплуатируете свой набор агентов, сессий сто-двести, и по ходу собираете боли: вот здесь агент систематически ошибается, вот тут критик пропускает целый класс проблем, вот там оркестратор теряет нить. Эти накопленные боли становятся входными требованиями. Промпты агентов вы подаёте архитектору и в actor-critic цикл — ровно как обычный артефакт: актор переписывает определение, критик проверяет. И конвейер чинит сам себя, встроенным в себя же паттерном.
Вот это для меня и есть главная мысль всей статьи. Конвейер получается самоулучшающимся (читатели Элияху Гольдратта вспомнят процесс непрерывного улучшения). Он чинит не только код, который вы им пишете, но и собственный инструмент, которым пишете. Это редкое свойство: система, которая улучшает не только свой продукт, но и себя.
И заметьте, что это свойство не случайно. Механика actor-critic вообще не привязана к природе артефакта. Ей всё равно, что перед ней — спека, код или промпт агента; ей нужен артефакт, автор и проверяющий, а больше ничего. Именно поэтому она одинаково переносится на все три уровня. А раз она переносится, значит, перед нами не приём, заточенный под одну задачу, а метод. Рекурсивность (фрактальность) здесь — не фокус, а признак того, что мы имеем дело с методом, применимым к самому себе.
Осталось разобрать, когда цикл останавливается, — иначе он крутился бы вечно. И здесь важно, что критерий сходимости составной: три условия одновременно.
Первое — критики апрувят без замечаний. Второе — объективные гейты зелёные: тесты проходят, линтер молчит, билд собирается. Третье — страховочный лимит итераций не исчерпан; если исчерпан, цикл не крутится дальше, а эскалирует к человеку.
Почему нужны все три, а не какое-то одно? Давайте разберём по отдельности. Если оставить только критиков — оценка субъективна: критик, даже хороший, может согласиться с красивым, но неработающим решением. Если оставить только гейты — они зелёные мимо смысла: код проходит тесты и линт, но делает не то, что просили; формально исправен, по сути бесполезен. А если убрать лимит итераций — вы рискуете бесконечным циклом, где актор и критик гоняют мяч по кругу, не сходясь. Только пересечение всех трёх даёт настоящую сходимость: и люди-в-роли-критиков довольны, и машина не возражает, и мы не ушли в бесконечность, а вовремя позвали человека.
Синтез: два кита в работе
Я пришёл к этому не сразу, и честно скажу, с чего начинал. Точкой входа для меня стал obra/superpowers и, в частности, скилл brainstorming. Именно оттуда я вытащил первые паттерны мышления о том, как вообще разговаривать с агентом не как с автодополнением, а как с исполнителем, которому нужен контекст и проверка. Дальше я стал писать собственные определения агентов — под свои роли, под свой процесс. А потом пришёл к openspec с его жёсткими артефактами, где спека перестала быть вольным текстом и стала структурой со своими правилами. Путь шёл от чужих паттернов мышления через свои определения агентов к дисциплине артефактов. Каждый шаг добавлял жёсткости — и, как ни странно, вместе с жёсткостью добавлял свободы, потому что рутина уходила в конвейер.
А теперь — зачем всё это, давайте на примере. Кейс успеха я вижу в трёх гранях, и они разные.
Грань первая — доведение до конца. Та самая длинная задача из пролога, на которой раньше всё разваливалось на полпути, теперь доходит до финала с нормальным качеством. Конвейер держит контекст и проверяет результат — и середина задачи перестаёт быть тем местом, где всё расползается. Причём качество тут не зафиксировано на какой-то отметке: оно растёт по мере того, как я прогоняю промпты агентов через третий уровень цикла. Инструмент затачивается, и вместе с ним поднимается планка того, что он делает.
Грань вторая — ретроспективная объяснимость. Накопленные спеки дают возможность через полгода ответить на вопрос «почему сделано так, а не иначе». Без артефактов этот ответ обычно утрачен — он уходит вместе с памятью участников, увольнениями, забыванием. А спека помнит: вот исходные требования, вот отвергнутые варианты, вот причина выбора. Это то знание, которое в обычной разработке испаряется первым, а здесь остаётся зафиксированным. И что более важно - лежит рядом с кодом, и не противоречит ему, потому что механизм openspec при работе поправит старые спеки если требования изменятся.
Грань третья — и она мне нравится больше всех — спеки как модель продукта. Когда я завожу новую фичу, агент опирается не на одну спеку, а на весь корпус накопленных. Он видит состав продукта целиком — из чего тот собран, какие фичи уже есть, — и заранее определяет, с какими из существующих новая фича может конфликтовать. Этот анализ совместимости люди регулярно упускают: держать в голове весь продукт мало кто может, и новая фича то и дело ломает старую в неожиданном месте. А агент, у которого перед глазами корпус спек, ловит конфликт до того, как он стал багом. И вот отсюда главное: ценность спек накопительная. Каждая спека полезна сама по себе, но корпус спек даёт качественно больше — он превращается в модель продукта, которой можно задавать вопросы.
Ну и мораль, ради которой всё писалось.
А мораль в том, что правильный конвейер агентской разработки держится на двух китах: контекст и цикл. Спеки и SDD — чтобы у агента было что положить на вход и чтобы договорённости пережили длину задачи. Actor-critic и его три уровня — чтобы выход был проверен, а сам инструмент со временем становился лучше. Инструмент, харнес, конкретный набор MCP — всё это безусловно важно, но вторично; спор «каким харнесом — не тот спор. А работа инженера при этом никуда не девается — она смещается. Из написания строчек кода она перетекает в проектирование контекста и проектирование циклов. Мы всё меньше пишем код руками и всё больше проектируем систему, которая пишет код за нас — и, если всё сделано правильно, чинит заодно и саму себя.
24.10.2025
В последнее время веду много архитектурных дискуссий, и в их рамках часто возникает необходимость определить некоторые элементы в системе и задать правила взаимодействия этих элементов. Чаще всего это делается через картинку с квадратиками и стрелочками между ними. Однако за этими квадратиками и стрелочками часто кроется недосказанность, которая потом проявляется при разработке или даже при эксплуатации системы.
Поэтому важно думать об этих квадратиках каким-то образом, чтобы эти недосказанности видеть в процессе проектирования или даже использовать их в проектировании. В своей работе я часто пользуюсь абстракцией компонента и предлагаю ее окружающим. В ходе этих предложений приходится про компонент рассказывать детально. Поэтому я решил написать эту статью, в которую поместить все те мысли, которые я произношу, чтобы был материал, во-первых, написанный, а во-вторых, доступный для чтения желающим.
Вот она, баллада о компоненте
Что такое компонент?
Для начала определим, что такое собственно компонент, обычно я даю такую картинку:
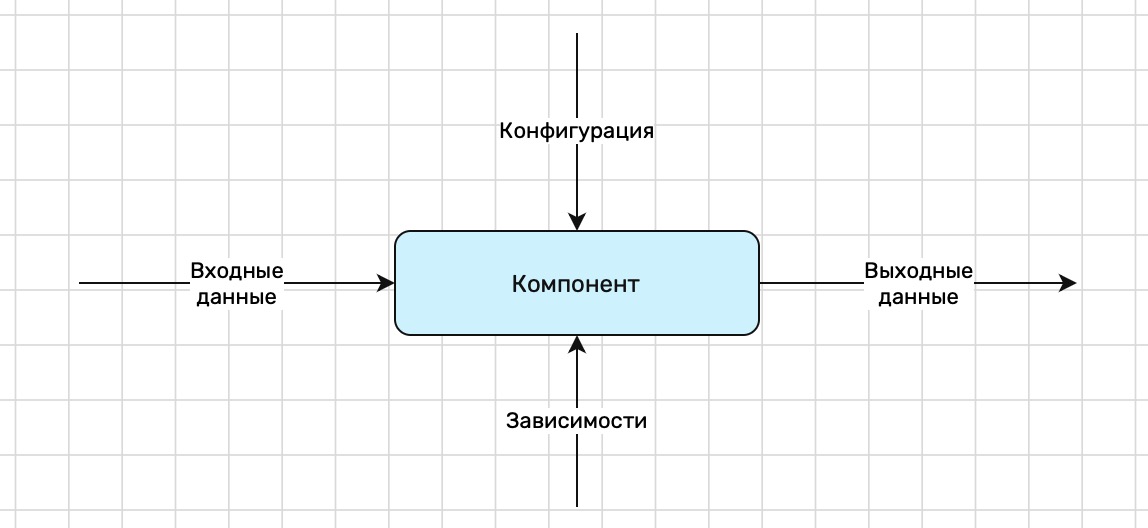
Если говорить нестрого, то компонент - это некоторая сущность, имеющая некоторое назначение и решающая какую-то одну задачу. Если задач несколько - то скорее всего мы имеем дело с несколькими компонентами и надо подумать над декомпозицией. К компоненту, уже по определению, применяется принцип SRP.
Для того, чтобы обсуждение было более наглядным, возьмем пример. Будем рассматривать такой компонент, как бариста.
У баристы есть назначение - он готовит кофе.
Однако, чтобы выполнить свое предназначение, любому компоненту нужны связи с внешним миром (с другими компонентами). Можно выделить четыре вида связи:
- Входные данные - набор входных условий, на основании которых компонент делает свою работу. Для нашего примера с баристой - входными данными являются заказы клиентов.
- Выходные данные - набор выходных артефактов, которые являются результатом деятельности компонента. Для примера с баристой - это чашка кофе по конкретному заказу клиента.
- Зависимости - ресурсы, артефакты, данные, которые использует компонент, чтобы преобразовывать входные данные в выходные. Для примера с баристой - это зерна кофе, вода, электричество, молоко и т.д.
- Конфигурация - специальные управляющие воздействия на то, как компонент делает свою работу. Для примера с баристой - это, например, меню от руководства, задающее доступные для заказа и приготовления напитки (т.е. например, даже если у нас есть молоко для капучино, мы можем намеренно его не готовить).
Для большего понимания, рассмотрим пример кода с баристой:
struct ClientAsk {
	enum CoffeeKinds {
		case americano
		case cappuccino
		// the rest ...
	}

	let coffeeKind: CoffeeKinds
	let withSugar: Bool
}

final class Barista {
	private let dependencies: BaristaDependencies
	private let menu: Menu

	init(dependencies: BaristaDependencies, menu: Menu) {
		self.dependencies = dependencies
		self.menu = menu
	}

	func makeCoffee(ask: ClientAsk) -> Result<Cup, BaristaErrors> {
		// use dependencies and menu to process client ask and make a cup of coffee
		// or report and error
	}
}
В данном случае
- Входные данные: ClientAsk, сущность, описывающая заказ клиента. Это то, что принимает компонент для одной итерации своей работы.
- Выходные данные: Result<Cup, Error>, тут стоит отметить важный факт, что результатом работы компонента может быть:
- успешное выполнение своих обязанностей, и тогда результатом этого будет некоторый артефакт (в нашем случае Cup) этой работы
- или сигнал о том, что работа в обычном виде выполнена быть не может (в нашем случае BaristaErrors), артефакт, описывающий причины того, почему работа не может быть сделана или почему не удалось ее выполнить (важно не забывать про эту часть)
- Зависимости: Dependencies, тут все что необходимо для приготовления чашечки кофе из заказа клиента
- Конфигурация: Menu, описывает виды кофе, которые можно сегодня приготовить
Зачем нам компонент?
С концепцией компонента разобрались, если будут вопросы - пишите, дополню статью. Теперь более насущный вопрос, а зачем нам компонент? Здесь надо сделать небольшое лирическое отступление.
Перед разработкой любой программной системы и при добавлении новой функциональности в уже имеющуюся, необходимо хорошо продумать что и как мы будем делать. Обычно я даже прошу написать что-то вроде RFC, в котором было бы явно описано что и как. Но чтобы разобраться что и как мы хотим делать (и даже написать RFC), необходимо к этому продумыванию как-то подойти. Декомпозировать задачу (которая, на самом деле, редко бывает сформулирована формально) на составляющие и обозначить между ними связи. А если система уже имеется, то еще и “прицепить” новую “запчасть” к тем что уже есть, ничего не забыть и сделать это правильно. И если мы будем мыслить систему в виде взаимодействующих друг с другом компонентов, то у нас будет хорошее подспорье к тому, чтобы задачу проектирования решить успешно.
К тому же, компоненты - фрактальны. Т.е. можно сделать несколько уровней не только в контексте кто кому предоставляет конфигурацию и зависимости, но и кто из кого состоит. Таким образом на одном уровне абстракции компонент может быть одним кубиком, а на другом - графом взаимодействующих друг с другом более низкоуровневых компонент.
Вернемся к нашему баристе, для пользователя это своего рода черных ящик - мы ему заказ, он нам чашечку кофе (или ошибку, не забываем!). Однако, если вы как клиент постоите и посмотрите на работу баристы, то заметите, что чашка кофе - результат последовательности действий. И таким образом компонент “Бариста” состоял бы из сети компонентов, в который входили бы: кофемолка, кофемашина, мойка для чашей, и т.д.
Поэтому компонент дает нам удобную абстракцию для анализа систем и синтеза решений.
Класс как компонент
Вооружившись абстракцией компонента, давайте посмотрим на привычные конструкции из программирования. Любой класс можно рассматривать как компонент. Вернемся к примеру с баристой выше
struct ClientAsk {
	enum CoffeeKinds {
		case americano
		case capuccino
		// the rest ...
	}

	let coffeeKind: CoffeeKinds
	let withSugar: Bool
}

protocol BaristaDependencies {
	var grinder: Grinder { get }
	var coffeeMachine: CoffeeMachine { get }
	var waterTap: WaterTap { get }
	// ...
}

protocol Menu {
	var isCappuccinoAllowed: Bool { get }
	// ...
}

final class Barista {
	private let dependencies: BaristaDependencies
	private let menu: Menu

	init(dependencies: BaristaDependencies, menu: Menu) {
		self.dependencies = dependencies
		self.menu = menu
	}

	func makeCoffee(ask: ClientAsk) -> Result<Cup, BaristaErrors> {
		// use dependencies and menu to process client ask and make a cup of coffee
		// or report and error
	}
}
Как я уже выше писал - это типичный компонент. Но давайте посмотрим на другие входящие в пример вещи. Является ли ClientAsk компонентом? А Cup? А BaristaDependencies? А Menu?
Интуиция подсказывает что скорее нет, ведь это всего лишь DTO (Data Transfer Object). Но это впечатление обманчиво - это тоже компоненты.
- ClientAsk и Cup это действительно DTO, объекты, чье единственное предназначение - перенос данных. Таким образом их входные и выходные данные хранятся напрямую в их полях и идентичны. Хотя порой такое бывает не всегда, и даже простые DTO могут на вход получать данные в одном виде, а на выходе давать в другом.
- BaristaDependencies как мы видим лишь контракт, который может скрывать в себе как просто прокси доступ к нужным объектам (про DI как-нибудь поразмышляю отдельно), так и какую-нибудь замысловатую логику получения этих объектов. На этом уровне контракт компонентом не является, но. Во-первых, является на другом, понятийном уровне, задача такого компонента - скрывать от пользователя реализацию получения зависимостей. Во-вторых, компонентом однозначно является реализация этого контракта.
- Menu является с одной стороны вариацией DTO’шки, с чуть более закрытым контрактом чем у ClientAsk например, а с другой стороны контрактом, который скрывает логику получения настроек (а она может быть весьма замысловатой). Как и BaristaDependencies, Menu является компонентом на понятийном уровне (если бы мы рисовали схемку, то Menu был бы квадратиком над стрелочкой), и реализация этого контракта также будет компонентом.
Модуль как компонент
Как я уже писал выше, компоненты фрактальны, а поэтому применять мы их можем не только к классам, но и к модулям. Таким образом у нас может быть модуль (давайте например думать в SPM-модулях для iOS/Swift) Баристы BaristaModule, который имеет Package.swift и в этом модуле лежит собственно исходный код по тому, как готовить кофе. Однако, реализовывать например, подачу воды или определение сортов кофе внутри этого модуля было бы неправильно, потому что подача воды и сорта кофе - это вещи, которыми пользуется не только бариста.
Таким образом мы могли бы определить еще модули, которые мы могли бы рассмотреть с позиции, что модуль BaristaModule - это компонент
- Входные данные: нам нужен способ получать заказы клиентов, поэтому входными данными может быть модуль заказов (AskModule), в котором определяются способы сделать заказ и формализуются для передачи баристе
- Выходные данные: нам нужен способ передать чашку клиенту, и здесь может быть модуль, который непосредственно доставляет чашку, например OfficientModule. К слову на вход и выход может работать один и тот же модуль официанта.
- Зависимости: как уже писал выше - это все что необходимо для баристы для работы, поэтому сюда все модули, которые предоставляют функционал баристе (WaterTap, MilkProvider, CoffeeMachine Shop, …).
- Конфигурация: тут модуль управления, например дирекция кофе-буфетов.
18.02.2025
Сегодня поговорим о том, почему сущности вырастают. Вроде бы маленькие и понятные, через какое-то время они становятся большими и непонятными. Напоминает ситуацию, как будто вы приручили маленького котенка, а он потом вырос в саблезубого тигра. Почему так происходит и что делать? Постараюсь на простых примерах поразмышлять над этим.
Почему?
Но начнем чуть издалека, рассмотрим такой пример. Нам надо включать лампочку. Оставим за скобками вечный вопрос сколько программистов для этого надо, и просто напишем код.
class Lamp {
    private(set) var isOn: Bool = false

    func switchOn() {
        isOn = true
        // do the actual switch
    }

    func switchOff() {
        isOn = false
        // do the actual switch
    }
}
Вроде бы все отлично и все понятно (я намеренно опустил логику переключения, она тут вторична). Эта лампочка уходит в релиз и все работает, все довольны.
Но это не конец истории, через, скажем, месяц, приходит продакт и говорит, а теперь нам нужны диммируемые лампочки (это такие у которых яркость можно измерять, очень полезно). И вроде бы отлично, диммируемые лампочки - это хороший продукт. Мы засучиваем рукава и смело в бой. Модифицируем наш класс
class Lamp {
    let isDimmable: Bool

    private(set) var isOn: Bool
    private(set) var dimValue: Double

    init(isDimmable: Bool, isOn: Bool = false, dimValue: Double = 0.0) {
        self.isDimmable = isDimmable
        self.isOn = isOn
        self.dimValue = dimValue
    }

    func switchOn() {
        isOn = true
        // do the actual switch
    }

    func switchOff() {
        isOn = false
        // do the actual switch
    }

    func dim(value: Double) {
        if (value > 0) {
            switchOn()
        }
        dimValue = value
        // do the actual dim
    }
}
и такой код даже будет работать. И вы даже быстро его напишите, и даже релиз случится. Но как мы видим, уже тут есть проблемы:
- комбинаторика состояний isOn и dimValue. Я добавил некоторую проверку в функции dim(value:) но легко мог ее забыть. И тогда лампочка начала бы вести себя странно.
- любая простая лампочка начинает знать про dimValue даже если она не dimmable.
прежде чем это все начинать фиксить, давайте еще усложним проблему. Продакты добавляют линейку устройств реле. Реле позволяет управлять не только светом, а например, чайником. Или светом но в выключателе. Или любым другим устройством которое можно включить в розетку. Отлично! Давайте чуть перепишем наш класс.
class SomethingSwitchable {
    let isDimmable: Bool
    let isRelay: Bool
    let switchCallback: ((_ isOn: Bool) -> Void)?

    private(set) var isOn: Bool
    private(set) var dimValue: Double

    init(isDimmable: Bool, isRelay: Bool, isOn: Bool = false, dimValue: Double = 0.0, switchCallback: ((_ isOn: Bool) -> Void)?) {
        self.isDimmable = isDimmable
        self.isRelay = isRelay
        self.switchCallback = switchCallback
        self.isOn = isOn
        self.dimValue = dimValue
    }

    func switchOn() {
        isOn = true
        // do the actual switch
        switchCallback?(isOn)
    }

    func switchOff() {
        isOn = false
        // do the actual switch
        switchCallback?(isOn)
    }

    func dim(value: Double) {
        if (value > 0) {
            switchOn()
        }
        dimValue = value
        // do the actual dim
    }
}

class Lamp: SomethingSwitchable {
    init(isDimmable: Bool, isOn: Bool = false, dimValue: Double = 0.0) {
        super.init(isDimmable: isDimmable, isRelay: false, isOn: isOn, dimValue: 0.0) { isOn in
            switch isOn {
            case false: // do the actual switch off
            case true: // do the actual swift on
            }
        }
    }
}

class Relay: SomethingSwitchable {
    init(isOn: Bool = false, switchCallback: ((Bool) -> Void)?) {
        super.init(isDimmable: false, isRelay: true, isOn: isOn, dimValue: 0.0, switchCallback: switchCallback)
    }
}
Я даже показал, как можно вынести общую логику в “базовый класс”. Но по приведенному коду видно что мы пошли не туда. И наша маленькая приятная лампочка превратилась в страшное нечто.
Как поправить?
Для начала давайте разберем мелкие правки которые можно было сделать, чтобы чуть спасти ситуацию. Эти техники могут быть полезны в целом взять на вооружение.
Я упоминал комбинаторику состояний isOn и dimValue. Пока опустим то, что лампочка и диммируемая лампочка могут быть разными сущностями, просто попробуем исправить ситуацию.
Для этого, обозначим, что isOn и dimValue не являются полностью независимыми, в данном примере dimValue имеет смысл только тогда, когда isOn = true. И, как гласит принцип “явное лучше неявного”, сделаем это явно и перепишем код так:
class Lamp {
    enum LampState {
        case off
        case on(value: Double)
    }

    let isDimmable: Bool

    private(set) var state: LampState

    init(isDimmable: Bool, state: LampState) {
        self.isDimmable = isDimmable
        self.state = state
    }

    func switchOn() {
        state = .on(value: 1.0)
        // do the actual switch
    }

    func switchOff() {
        state = .off
        // do the actual switch
    }

    func dim(value: Double) {
        state = .on(value: value)
        // do the actual dim
    }
}
За счет явного введение LampState мы отразили любому читающему наш код, как работает состояние нашей лампочки. И даже код в dim(value:) стал более понятным - мы явно включим лампочку и включим ее в нужное состояние сразу (она не будем промаргивать через состояние 1.0).
Также можно явно заметить, что тип Double по области значений явно шире, чем нам надо. Явно диммирование управляется через диапазон 0-1. И это тоже можно явно отразить, опять же, явное лучше неявного.
struct DimValue {
    private static let minimum = 0.0
    private static let maximum = 1.0
    private(set) var value: Double

    init(value: Double) {
        self.value = Self.clamp(value, min: Self.minimum, max: Self.maximum)
    }

    private static func clamp(_ value: Double, min: Double, max: Double) -> Double {
        return Swift.max(min, Swift.min(value, max))
    }

    mutating func setValue(_ newValue: Double) {
        value = Self.clamp(newValue, min: Self.minimum, max: Self.maximum)
    }

    public static let max = DimValue(value: Self.maximum)
}

class Lamp {
    enum LampState {
        case off
        case on(value: DimValue)
    }

    let isDimmable: Bool

    private(set) var state: LampState

    init(isDimmable: Bool, state: LampState) {
        self.isDimmable = isDimmable
        self.state = state
    }

    func switchOn() {
        state = .on(value: .max)
        // do the actual switch
    }

    func switchOff() {
        state = .off
        // do the actual switch
    }

    func dim(value: DimValue) {
        state = .on(value: value)
        // do the actual dim
    }
}
Таким образом мы увидим несоответствие кода сразу же, да еще и компилятором проверим.
Меня можно укорить в том, что я на самом деле увеличил объем кода по сравнению с моей же реализацией диммируемой лампочки. Да, кода стало чуть больше, но он стал более явно выражать то, что он делает, без предположений существующих только в головах.
Теперь давайте рассмотрим более фундаментальную проблему - у нас все лампочки диммируемые. Даже те, которые нет. И на самом деле поле isDimmable не сильно помогает решить проблему, потому что как вы можете заметить, оно устанавливается в конструкторе, но нигде не используется - про него забыли.
И попутно непонятно, а как теперь быть лампочкам недиммируемым? Игнорировать значение диммера?
Давайте начнем приводить код в чувство, попутно учитывая будущее когда у нас появится реле.
Формально - у нас есть три сущности:
- Что-то что может включаться
- Что-то что может диммироваться
- Что-то что может включать других (ака реле)
На самом деле наш код базовой реализации класса SomethingSwitchable дает еще и четвертый вариант, что-то вроде “диммируемого реле”, которое на самом деле может быть регулятором скорости/яркости.
Попутно вспомним Interface Segregation Principle и заведем такие сущности.
Для начала что-то, что может переключаться
protocol Switchable {
    var isOn: Bool { get }

    func switchOn()
    func switchOff()
}
Это может быть лампочка, может быть реле. Далее, что-то что можно диммировать
protocol Dimmable {
    var dimValue: DimValue { get }

    func dim(value: DimValue)
}
И наконец, что-то, что может управлять другими
protocol Controling {
    func setSwitchCallback(_ switchCallback: @escaping (_ isOn: Bool) -> Void)
}
Теперь у нас есть базовые кубики, из которых мы можем строить что-то более сложное.
Простую лампочку сделаем так
class YablochkovLamp: Switchable {
    private(set) var isOn: Bool = false

    func switchOn() {
        isOn = true
        // do the on logic
    }

    func switchOff() {
        isOn = false
        // do the off logic
    }
}
Заметьте, она может включаться/выключаться, ее состояние простое. Оно не искажается состоянием диммируемой лампочки и может использовать простое булево значение (вопросы thread-safety пока опустим).
Диммируемая лампочка будет такой:
class DimmableLamp {
    private enum State {
        case off
        case on(value: DimValue)
    }

    private var state: State = .off
}

extension DimmableLamp: Switchable {
    var isOn: Bool {
        switch state {
        case .off: return false
        case .on: return true
        }
    }

    func switchOn() {
        state = .on(value: .max)
        // do the logic
    }

    func switchOff() {
        state = .off
        // do the logic
    }
}

extension DimmableLamp: Dimmable {
    var dimValue: DimValue {
        switch state {
        case .off: return .min
        case let .on(value): return value
        }
    }

    func dim(value: DimValue) {
        state = .on(value: value)
        // do the logic
    }
}
Тут отметим, что на уровне типов можно явно отметить, что эта лампочка диммируемая, теперь сложно об этом забыть. Кроме того, я показал, что с помощью extension’ов можно расширить логику после создания типа (ретроактивно). И в довесок спрятал от внешнего наблюдателя внутреннее состояние лампочки.
Ну и теперь реле:
class Relay {
    private(set) var isOn: Bool = false
    private var switchCallback: ((_ isOn: Bool) -> Void)?
}

extension Relay: Switchable {
    func switchOn() {
        isOn = true
        switchCallback?(isOn)
    }

    func switchOff() {
        isOn = false
        switchCallback?(isOn)
    }
}

extension Relay: Controling {
    func setSwitchCallback(_ switchCallback: @escaping (Bool) -> Void) {
        self.switchCallback = switchCallback
    }
}
Как видим состояние реле проще состояние диммируемой лампочки (не надо явно учитывать сайд эффект и понятно), но при этом функциональность реле реализована так, как надо.
Такая детализация позволяет:
- Строить сущности из кубиков (я не упоминул еще о дефолтных реализация в протоколах, что тоже улучшает ситуацию)
- Уменьшать комбинаторный взрыв за счет разделения и в целом упрощать реализацию сущностей
- Заменять конкретные классы в процессе развития кода на другие, удовлетворяющие контракту.
Про третий пункт отдельно. Например, лампочка у нас “уехала” на другой хост в ip сети, и чтобы скрыть от управляющего кода этот факт и не делать его сложнее чем надо, мы можем изобрести такую связку проксей:
class SwitchableProxyClient: Switchable {
    // private let network: NetworkClient

    var isOn: Bool {
        // network.proxyIsOn
        return false
    }

    func switchOn() {
        // network.proxySwitchOn()
    }

    func switchOff() {
        // network.proxySwitchOff()
    }
}

class SwitchableProxyServer {
    private let switchable: Switchable
    // private let networkServer: NetworkServer

    init(switchable: Switchable) {
        self.switchable = switchable
        // networkServer.switchOn = {
        //   switchable.switchOn()
        // }
        // networkServer.switchOff = {
        //   switchable.switchOff()
        // }
        // networkServer.isOn = {
        //   switchable.isOn
        // }
    }
}
и благодаря им, управляющий код не будет знать, что лампочка “уехала”, а в проксе можно реализовать гарантии надежности для всех, кто может быть Switchable.
А мораль?
А мораль в том, что, когда вы пишите или что еще более важно модифицируете какую-то сущность, хорошо бы подумать о том, как ваша модификация сказывается на том, чем сущность является. Не превращаете ли вы ее в франкенштейна и может быть ее стоит подробить на концепции и эти концепции использовать.
В конце концов, то как вы обозначили контракт вашей сущности влияет на то, как ее используют. И как понимают в целом, что это.
08.04.2024
Тема внедрение зависимостей одна из краеугольных в целом при любой разработке. И, благодаря этому, одна из наиболее дискуссионных, порой доходящаяя до уровня “священных войн” между апологетами разных подходов. В этой статье постараюсь изложить свое видение подходов к решению проблем.
Преамбула
Для того, чтобы не превращать эту статью в рассказ “от сотворения мира”, очень рекомендую посмотреть это видео (с указанного таймкода, лекция там в целом про архитектуру, но нас в рамках этой статьи будут интересовать выкладки про DI).
Постановка проблемы
Базовая задача
Итак, мы стараемся придумать решение следующей проблемы
-
protocol SomeBookService { /* ... */ }

class BookProcessor {
    let service: SomeBookService = SomeBookServiceImpl()
}
-
interface SomeBookService { /* ... */ }

class BookProcessor(
    private val service: SomeBookService = SomeBookServiceImpl()
)
Что мы хотим от хорошего решения?
- Через протокол/интерфейс. Использующий зависимость класс не должен знать о конкретной реализации и должен иметь работать с любой реализацией правильно реализующей контракт (объявленный в протоколе/интерфейсе).
- Узкий контракт. Реализация, которую мы получаем в виде зависимости должена иметь минимально необходимый контракт. Наша сущность не должна видеть лишнего
- Необходимость и достаточность. Поставляемые зафисимости поставляются в необходимом и достаточном объеме, не требуется каких-то специальных приседаний для того, чтобы получить что-то еще (это как правило относится к запрету использовать внутри синглтоны).
- Реализация DI для логического кода “невидима”. Мы не должны видеть фрагменты порождающего кода где-либо (кроме некоторых исключений).
Платформенные особенности
Мы рассматриваем мобильные платформы (в целом можно рассматривать и серверные, но там как правило все проще в этом плане).
iOS
Как правило, все сущности iOS позволяют нормально реализовать constructor injection паттерн без необходимости построения специальных решений. Иногда требуются специальные действия для создания циклических зависимостей, но они легко решаются способами, описанными ниже.
Единственный объект, который система создает сама - это UIApplication (и applicationDidFinishLaunchingWithOptions) или SwiftUI объект обозначенный как @main. Но эти объекты будем считать точкой входа и растить графы от них.
Android
У Android также как и в iOS есть главный объект создаваемый системой - Application, но есть и важное отличие - в Android есть объекты, которые фреймворком могут быть убиты и пересозданы через тривиальный конструктор, такие как Activity, Fragment, View и тд. И есть общепринятая практика использовать для иньекции зависимостей в такие объекты через паттерн Service Locator. Service Locator считаем антипаттерном (как минимум он противоречит принципам хорошего решения, упомянутым выше).
Поэтому для решение проблемы спец сущностей (которые могут быть пересозданы), в Android надо предусмотреть дополнительные средства.
O Service Locator’е
Service Locator это такой паттерн проектирования, который, упрощенно говоря, предоставляет единую точку, через которую можно запросить разные зависимости. В рамках создания библиотек для DI он обычно соседствует с паттерном Singleton предоставляя публично известный разделяемый объект, из которого можно запросить практически все что угодно.
Я считаю его антипаттерном в применении к задачам DI (у него есть другая применимость, которая норм).
Но чтобы не быть голословным, давайте рассмотрим поставленные требования к хорошему решению:
- Через протокол/интерфейс - эту задачу в целом можно решить, отдавая из публичного singleton’а сервис локатора интерфейсы
- Узкий контракт - так как точка эта общеизвестная, то надо отдавать зависимость целиком, что нарушает принцип сужения контракта. Можно из публичного singleton’а отдавать одну реализацию под набором интерфейсов, но тогда у нас будет очень сложно выглядеть общий контракт такого объекта, сложно будет что-то в нем найти.
- Необходимость и достаточность - мы показываем всевозмоюжные интерфейсы или даже реализации, что любой клиент может видеть все приложение, что явно нарушает это требование
- “Невидимость” - требование явно нарушается, так как из любой точки приложения можно публичный singleton локатора
Таким образом Service Locator использовать не стоит, поэтому будем строить решение на базе концепции контейнера.
О библиотечных решениях
В мире написано огромное количество библиотек, заявляющих что так или иначе решают проблему внедрения зависимостей. Однако большая часть из них основана на паттерне Service Locator. Справедливости ради стоит сказать, что наиболее популярная библиотека Dagger 2 для Android пытается использовать концепцию контейнера, и в Sevice Locator его чаще всего превращают при использовании.
Идея решения проблемы
Как уже было сказано выше - будем использовать концепцию контейнера.
Контейнер - это такая сущность, которыя
- Создает нужные объекты и управляет их временем жизни
- Настраивает связи между ними
- Невидима для самих объектов
Каждая конкретная логическая сущность (кроме самих контейнеров) заявляет необходимость зависимостей (через constructor или property injection) и все. Никоим образом логическая сущность не получает доступа не к типу контейнера, ни к его инстансу (кроме как через Factory интерфейсы там где нужна prototype зависимость).
Отступление про нейминг. Однажды я увидел, как в коде контейнеры называют графами (Graph) и мне эта идея так понравилась, что далее буду называть типы контейнеров графами, можно в рамках этой заметки считать эти термины эквивалентными для задач DI.
Таким образом простейший контейнер может выглядеть так
-
final class SomeGraph {

    // 'singleton' entities
    private let dep1: Dep1
    private let dep2: Dep2
    private let dep3: Dep3

    // other graphs
    private let subGraph: SomeSubGraph

    init(
        someGraphDependencies: SomeGraphDependencies,
        someSpecificDependency: SomeSpecificDependency,
        configuration: SomeGraphConfiguration,
        ...
    ) {
        self.dep1 = Dep1(
            /* ... */,
            makeSome: {
                return self.makeSomePrototypeDep(val: configuration.val)
            }
        )
        self.dep2 = Dep2(/* ... */, useVal: configuration.useVal)
        self.dep3 = Dep3(dep1: Dep1, dep2: Dep2)
        // ...
        self.subGraph = SomeSubGraph(
            /* ... */
        )
    }

    deinit {
        // тут некоторая логика очистки сущностей, которые того требуют
    }

    // 'prototype' entities
    private func makeSomePrototypeDep(val: Val1) -> Dep4 {
        // ...
        return Dep4(
            val: val
        )
    }
}
-
class SomeGraph(
    someGraphDependencies: SomeGraphDependencies,
    someSpecificDependency: SomeSpecificDependency,
    private val configuration: SomeGraphConfiguration,
    ...
) {

    // 'singleton' entities
    private val dep1: Dep1
    private val dep2: Dep2
    private val dep3: Dep3

    // other graphs
    private val subGraph: SomeSubGraph

    init {
        this.dep1 = Dep1(
            /* ... */,
            makeSome = {
                return makeSomePrototypeDep(val = configuration.val)
            }
        )
        this.dep2 = Dep2(/* ... */, useVal = configuration.useVal)
        this.dep3 = Dep3(dep1 = Dep1, dep2 = Dep2)
        // ...
        this.subGraph = SomeSubGraph(
            /* ... */
        )
    }

    fun cleanup() {
        // в Java/Kotlin нет полноценных деструкторов, поэтому cleanup методы
        // необходимо будет вызывать руками
        // тут некоторая логика очистки сущностей, которые того требуют
    }

    // 'prototype' entities
    private fun makeSomePrototypeDep(val: Val1): Dep4 {
        // ...
        return Dep4(
            val = val
        )
    }
}
И все - собирайте нужную конструкцию из иерархических графов. Когда какой-то набор сущностей станет ненужным - зануляете граф и все очищается (в Android не забываем звать cleanup).
PROFIT? не совсем, есть тонкости
iOS
В iOS как правило все проходит без проблем. Мы создаем корневой граф-контейнер в applicationWill/DidLaunchingWithOptions и передаем его целиком или частями в дальнейшие сущности, или создаем его в корневом объекте помеченном @main и также передаем целиком или частями дальше. Главное не забывать о сужении интерфейсов и принципе достаточной необходимости.
Android
Для бизнесовых сущностей достаточно также в рамках класса Application создать корневой граф и действовать аналогично iOS, но, как я уже выше упоминал, есть проблемы с андроидными сущностями. Поэтому для них нужно специальное решение.
Заведем пару контрактов
// любая сущность, в которую наш DI сможет что-то инжектить
interface Injectable

// контракт сущности контейнера, который сможет что-то куда-то инжектить
interface Injector {
    fun inject(into: Injectable) // можно опционально return Result
}
Чуть выше в разделе про Service Locator я уже говорил, что основная проблема в нем в том, что
- его shared instance известен публично, и может быть использован скрыто. С этим увы ничего не поделать, андроидные компоненты устроены так, что нам придется пойти на открытие какого-то shared instance. Для activity/fragment есть лазейка, о ней чуть позже, но в общем итоге не поделать ничего.
- из него можно достать что угодно, эту проблему будем решать.
Также важно, что для Android компонентов инъекция будет асинхронной относительно вызова конструктора объектов, поэтому полноценную compile time проверку мы сделать не сможем. Ограничимся сокрытием лишней информации.
Теперь нам нужно предусмотреть сущность, которую мы будем видеть через shared instance, но не моч из нее ничего достать
class SomeGraph private constructor(
    private val dependency: SomeDependnecy,
    // other deps
): Injector {
    override fun inject(target: Injectable) = when (target) {
        is SomeKnownFragment -> {
            target.dependency = dependency
        }
        else -> {
            // report error in some kind
        }
    }

    companion object {
        var sharedInstance: SomeGraph? = null
            private set

        fun setup(
            dependency: SomeDependency
        ) {
            synchronized(this) {
                if (sharedInstance != null) {
                    return
                }
                sharedInstance = SomeGraph(
                    dependency = dependency
                )
            }
        }
    }
}
И теперь в условном фрагменте мы можем написать так
class SomeKnownFragment: Fragment(), Injectable {

    lateinit var dependency: Dependency? = null

    override fun onAttach(context: Context) {
        super.onAttach(context)
        SomeGraph.sharedInstance?.inject(this)
    }
Как я уже сказал, есть некоторая проблема в том, что связывание будет проверено только в runtime, а правильнее было бы сделать в compile time, но архитектура компонентов Android’а тут этому препятствует.
К слову такой подход хорошо подходит для библиотек, этот SomeGraph может быть объектов библиотеки, которую надо проинициализировать и потом сама библиотека будет ее использовать. Для Activity/Fragment и тд можем сделать лучше, для этого нам потребуется еще немножко сахара (покажу на примере Activity, для фрагментов можно сделать аналогично)
fun Activity.inject() {
    val thisAsInjectable = this as? Injectable ?: throw InjectException("activity not injectable")
    val application = application ?: throw InjectException("application isn't set to activity")
    val injector = application as? Injector ?: throw InjectException("application is not an injector")
    injector.inject(thisAsInjectable)
}
теперь надо класс приложения разметить соответствующим образом
class YourApp: Application(), Injector {

    private lateinit var rootGraph: RootGraph

    override fun onCreate() {
        super.onCreate()
        rootGraph = RootGraph(this)
    }

    override fun inject(target: Injectable) {
        if (!this::graph.isInitialized) {
            error("Application isn't properly initialized yet")
        }
        graph.inject(target)
    }
}
корневой граф будет выглядеть примерно так
class RootGraph(
    applicationContext: Context
): Injector {

    // private val yourdeps = ...

    init {
        // тут инициализация нужных компонентов
    }

    override fun inject(target: Injectable) {
        when (target) {
            is MainActivity -> {
                target.depepdency = ...
            }
            // можно делегировать что-то субграфам
        }
    }
}
И в самой активити будет просто
class MainActivity : Activity(), Injectable {

    override fun onCreate(savedInstanceState: Bundle?) {
        super.onCreate(savedInstanceState)

        inject()

        // остальная инициализация
    }
}
Никаких синглетонов и никакого раскрытия лишних зависимостей - PROFIT.
P.S. Если придумаете как решить эту проблему с аналогичными гарантиями да еще и в compile time буду благодарен